管理员指南
计费表达式
Root 使用计费表达式为模型定价:编辑器与预设、价格参数与用量变量、函数与语法、请求规则、费用估算与请求模拟,以及预扣、结算和保存校验规则。
计费表达式简介
- 一条计费表达式完整定义一个模型的计价:Token 单价、阶梯条件、缓存 / 图片 / 音频的区分、按次价格和请求规则倍率都写在同一条表达式中,不再叠加旧的模型倍率、补全倍率等配置;分组倍率照常生效。
- 计费表达式在定价编辑器中配置,有三种方式可以打开:
「系统设置 → 计费与支付 → 模型定价」、「模型」列表中某个模型的「定价」页,模型编辑抽屉的「定价」标签。 - 仅 Root 可以查看和修改模型价格。
| 项目 | 说明 |
|---|---|
| 单位 | Token 系数为美元 / 百万 Token,p * 2.5 表示输入每百万 Token 2.5 美元;fixed(0.01) 表示每次请求 0.01 美元。 |
| 换算 | 额度 = 表达式结果 ÷ 1,000,000 × 每美元额度(默认 500,000)× 分组倍率,四舍五入。 例如 tier("base", p * 2 + c * 8),输入 1,000、输出 500 Token、分组倍率 1 时,结果为 6,000,即 0.006 美元,按默认每美元额度扣 3,000 额度。fixed() 的金额在内部同样乘以 1,000,000 计入结果,因此同样条件下 fixed(0.01) 每次扣 5,000 额度。 |
| 版本前缀 | 表达式可以 v1: 开头,不写时按 v1 处理。 |
| 内置表达式 | gpt-image-2、gpt-6-astra、deepseek-v4-pro 等模型自带计费表达式。 |
| 旧模式 | 「按 Token(已弃用)」「按次(已弃用)」仍可运行,转换方法见从旧模式转换。 |
编辑器
编辑器结构
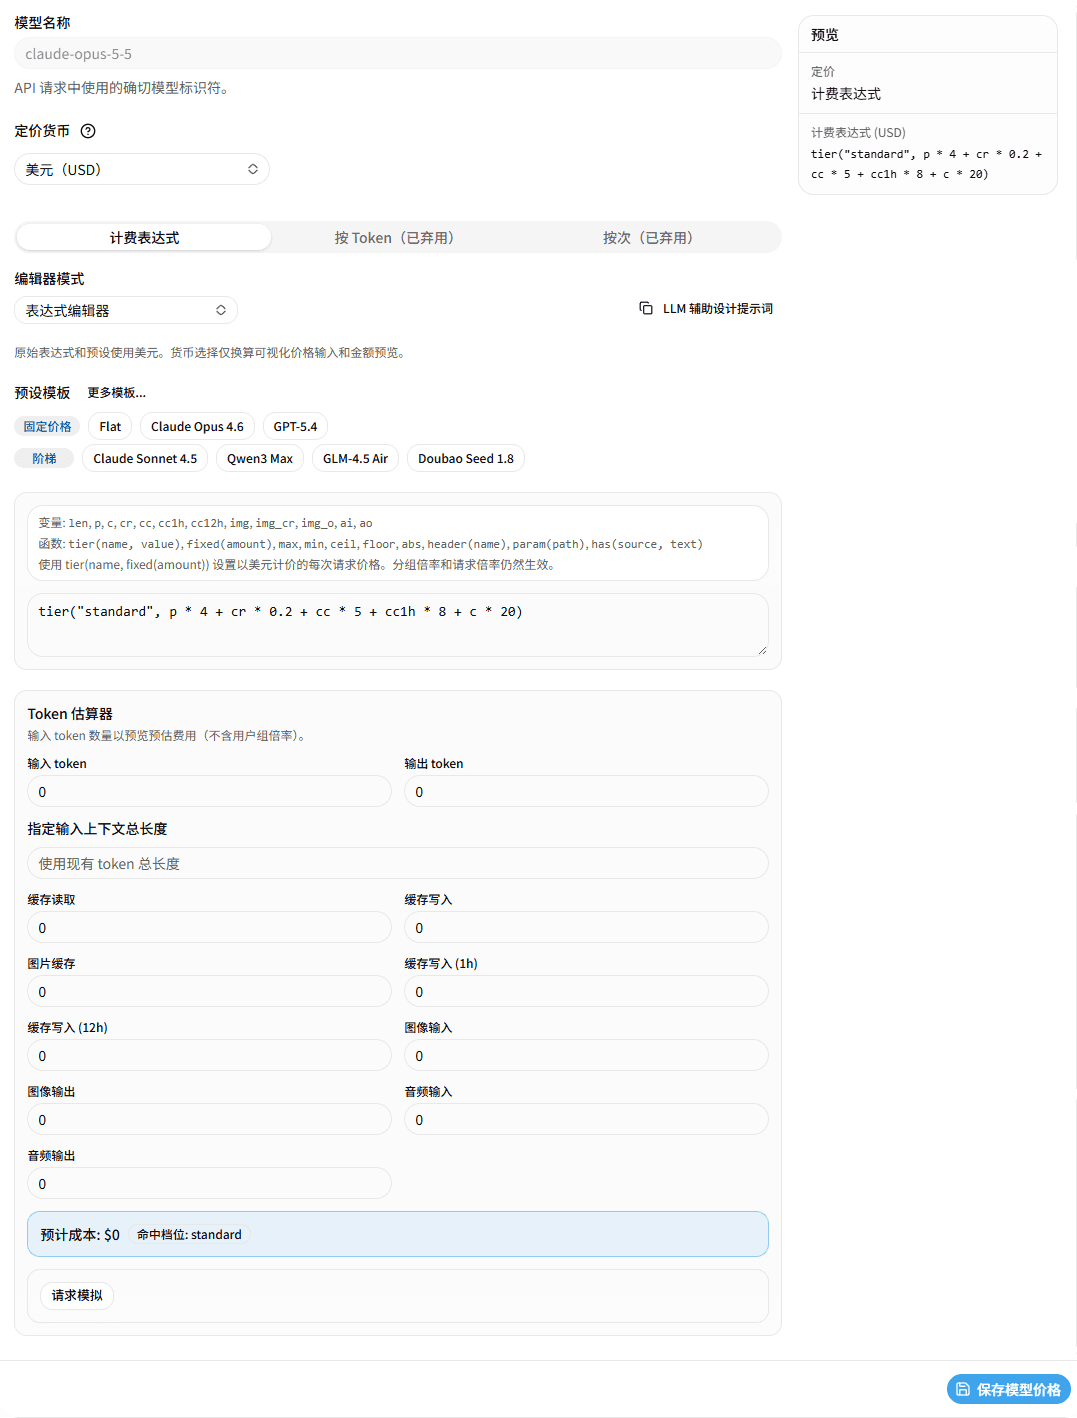
- 计费表达式-表达式编辑器
- 计费表达式-可视化编辑器(单一默认档位)
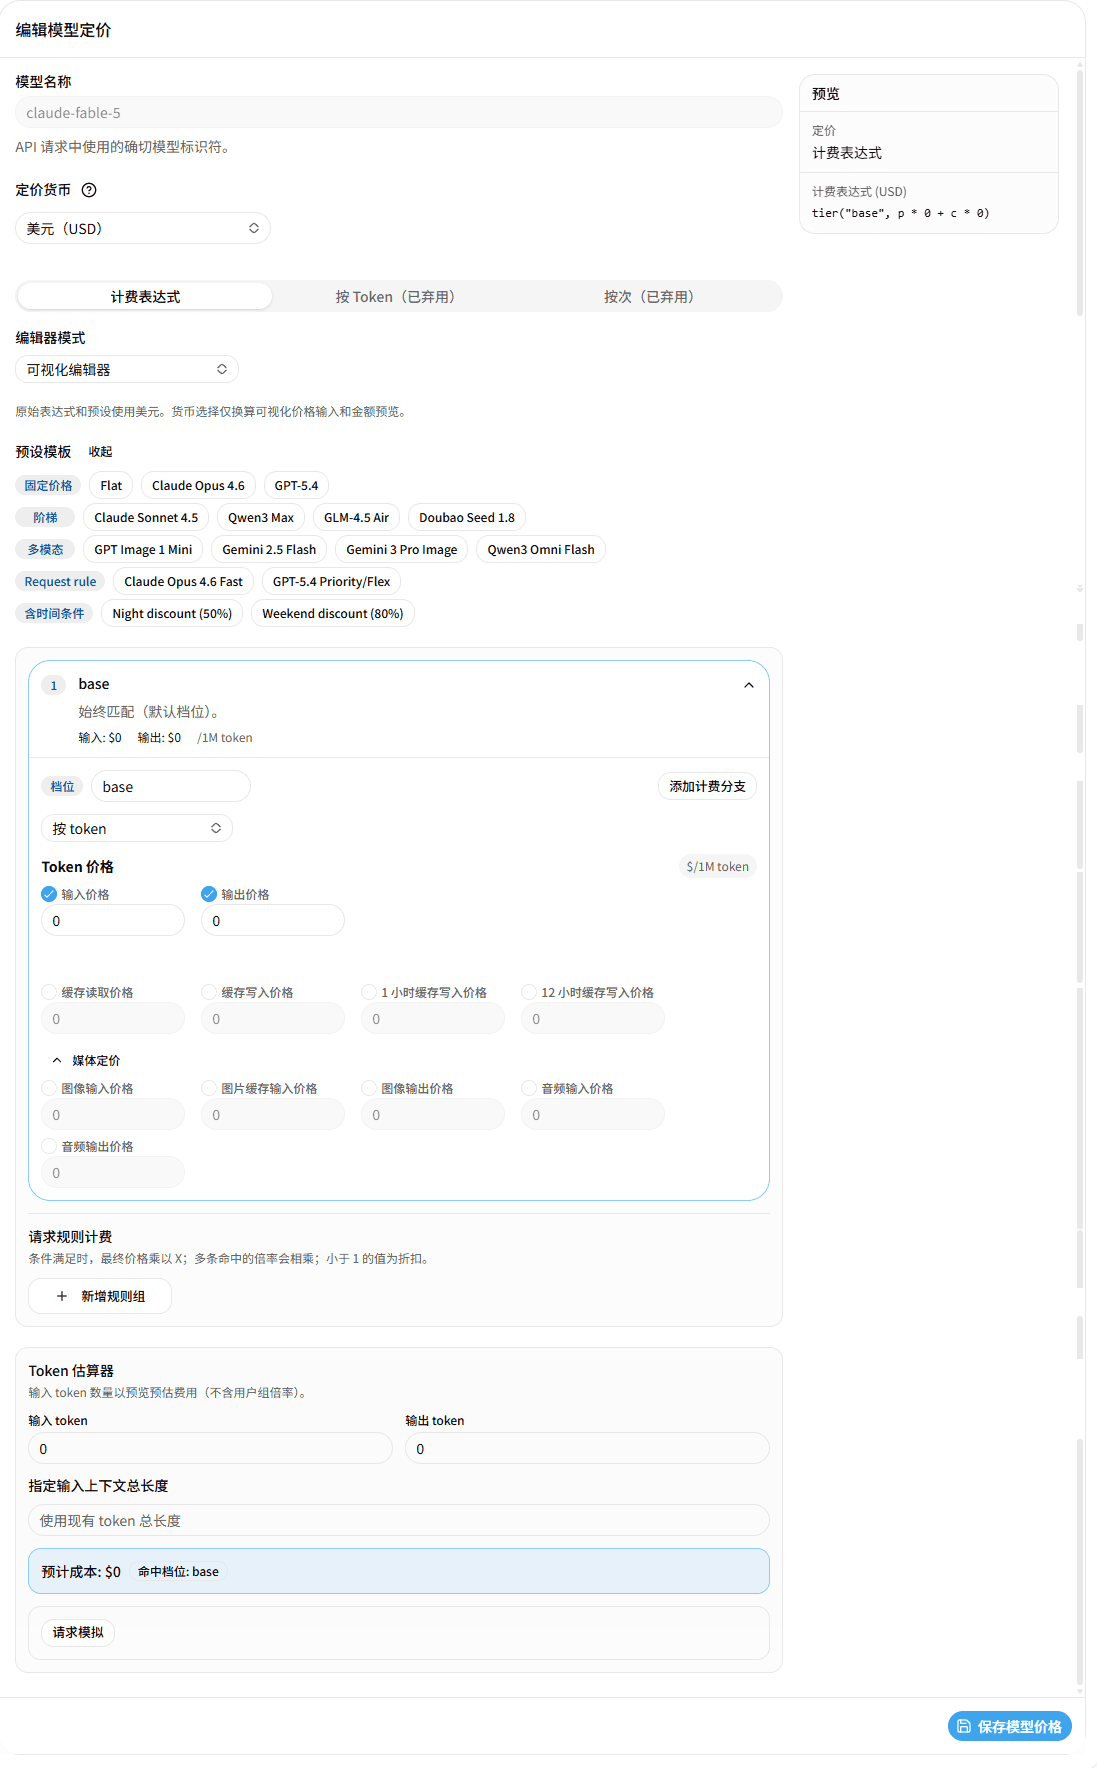
面板顶部依次为「模型名称」「定价货币」和计费模式标签,选择「计费表达式」后显示下列内容(模型名称与定价货币见计费与支付配置中的基础字段):
| 页面字段 | 默认或填写要求 | 说明 |
|---|---|---|
| 编辑器模式 | 「可视化编辑器」或「表达式编辑器」 | 原始表达式和预设使用美元。货币选择仅换算可视化价格输入和金额预览。可视化草稿有无效字段时不能切换到表达式编辑器;表达式无法完整还原为可视化结构时,提示「此表达式无法无损转换为可视化编辑。」并停留在表达式编辑器。 |
| 预设模板 | 按实际模型选择 | 默认显示「固定价格」「阶梯」两组,点击「更多模板...」再显示「多模态」「Request rule」「含时间条件」,此时按钮变为「收起」。应用预设会替换当前编辑内容,仍需核对和保存。 |
| 档位名称 | 为各档位使用可识别名称 | 用于标识命中的价格档位,例如 base、standard。命中的档位名会记入消费日志。档位即表达式中的一个 tier();界面中的「阶梯」与档位同义,「添加计费分支」添加的是带条件的档位。 |
| 阶梯条件 | 按业务设置 | 可选「完整输入长度」「计费输入 token」「计费输出 token」,以及「小时」「分钟」「星期」「月份」「日期(日)」(时间项需选时区);可「新增条件」「添加条件组」,组内选择「全部满足」或「任一满足」,也可「取反」。按长度分档时使用「完整输入长度」(len),不要用「计费输入 token」(p):缓存命中会让 p 变小而误判档位。 |
| 添加计费分支 | — | 点击「添加计费分支」可添加计费阶梯条件:在当前档位前插入一条带条件的分支;规则从前向后匹配,首条命中决定档位。 |
| 兜底阶梯 | — | 兜底档位处理此前均未命中的请求,卡片显示「前面的规则均未命中」。只有一个档位时,该卡片显示「始终匹配(默认档位)。」,不带「兜底阶梯」标记。 |
| 分支计费方式 | 「按 token」或「每次调用」 | 按 token 时填写下方 Token 价格(价格单位见下节);每次调用时填写「每次请求价格」,单位为所选定价货币 / 请求。表达式用到 image_count 的图片模型,「每次调用」选项和「每次请求价格」都显示为「每张图片价格」。 |
| 预览 | — | 面板右侧「预览」显示定价方式和「计费表达式 (USD)」全文。编辑只修改草稿,点击「保存模型价格」后才提交。 |
Token 价格与媒体价格
每个档位的价格项前有勾选框,勾选后才单独计价;未勾选的缓存、图片、音频用量仍计入输入或输出,按输入或输出价格计费。可视化编辑器中的价格单位为所选定价货币 / 1M token,表达式中的系数始终为美元 / 1M token。「媒体定价」默认折叠,已有媒体价格时自动展开,也可点击「媒体定价」手动展开或收起。
| 参数名称 | 表达式变量 | 定义说明 |
|---|---|---|
| 输入价格 | p | 输入 Token 的基础单价。 |
| 输出价格 | c | 模型输出 Token 的基础单价。 |
| 缓存读取价格 | cr | 复用已有提示词缓存时,命中缓存的输入 Token 单价。 |
| 缓存写入价格 | cc | 标签默认为「缓存写入价格」;勾选「1 小时缓存写入价格」时显示为「缓存创建 (5m)」(同时勾选 12 小时也是如此),只勾选「12 小时缓存写入价格」时显示为「缓存创建 (30m)」。对应 Claude 的 5 分钟、OpenAI 的 30 分钟缓存写入,其他上游为通用缓存写入。 |
| 1 小时缓存写入价格 | cc1h | 创建有效期为 1 小时的提示词缓存时,写入缓存的 Token 单价。Claude 专用;未勾选时按缓存写入价格的 1.6 倍(6 ÷ 3.75)计费。 |
| 12 小时缓存写入价格 | cc12h | OpenAI 创建有效期为 12 小时的提示词缓存时,写入缓存的 Token 单价;未勾选时按缓存写入价格的 2 倍计费。 |
| 图像输入价格 | img | 输入图片对应的图像 Token 单价。 |
| 图片缓存输入价格 | img_cr | 命中缓存的图像输入 Token 单价;需要上游提供有效的图片缓存用量明细。 |
| 图像输出价格 | img_o | 模型生成图片对应的图像输出 Token 单价。 |
| 音频输入价格 | ai | 输入音频对应的音频 Token 单价。 |
| 音频输出价格 | ao | 模型生成音频对应的音频 Token 单价。 |
缓存写入价格也未勾选时,长效缓存写入按输入价格乘以上述倍数计费。
请求规则计费
- 计费表达式-阶梯条件、兜底阶梯与请求规则
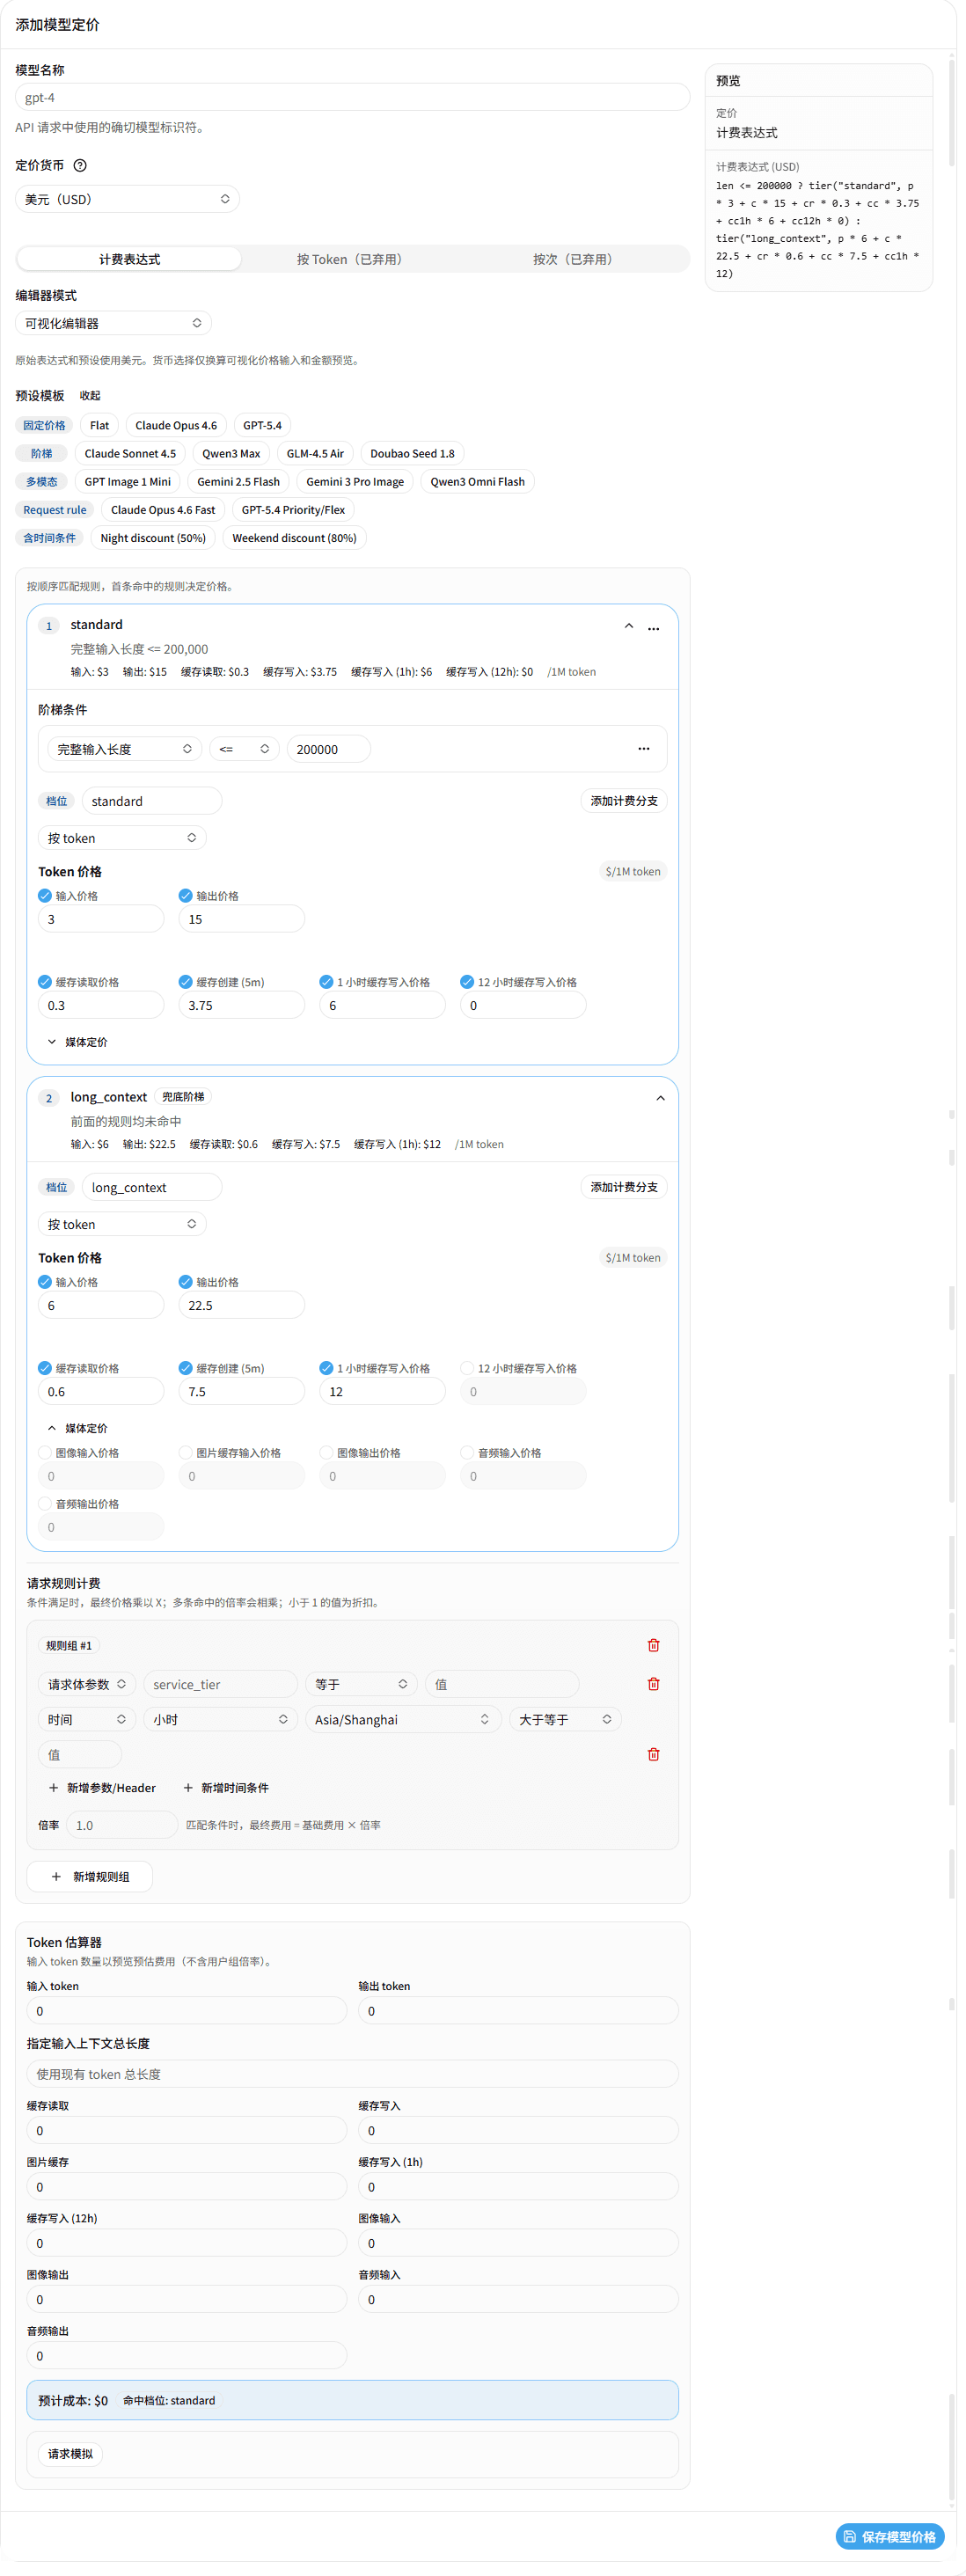
「请求规则计费」只在可视化编辑器中显示。条件满足时,最终价格乘以倍率;多条命中的倍率相乘,小于 1 的值为折扣。点击「新增规则组」添加规则组,组内用「新增参数/Header」「新增时间条件」添加条件,同组条件全部满足才命中。
| 字段或操作 | 填写要求 | 说明 |
|---|---|---|
| 请求体参数 | 参数路径、比较方式和值 | 读取请求 JSON 路径;例如按 service_tier 区分服务等级。比较方式为「等于」「包含」「存在」「大于」「大于等于」「小于」「小于等于」。读取的是客户端发来的原始 JSON 请求体。 |
| 请求头 | Header 名称、比较方式和值 | 根据实际发送的请求头匹配。比较方式为「等于」「包含」「存在」。 |
| 时间 | 时间项、时区、比较值或范围 | 明确时区,例如 Asia/Shanghai。时间项为「小时」「分钟」「星期」「月份」「日期(日)」,比较方式为「等于」「大于等于」「小于」「时间范围」;时间范围含起点、不含终点,起点大于终点时表示跨午夜,例如 21 到 6。 |
| 倍率 | 填入业务所需倍率 | 同组条件同时满足才命中;多个命中组的倍率相乘,小于 1 表示折扣。 |
- 规则保存为普通乘法,附加在基础表达式之后:
(基础表达式) * (条件 ? 倍率 : 1),切换到表达式编辑器可见。只有条件引用了param、header或时间函数、命中值为数字、未命中值为1的因子,才会作为请求规则记入消费日志。 - 规则过于复杂时显示「此表达式对可视化编辑器过于复杂,请切换到表达式模式进行编辑。」
- 按
service_tier等请求参数加价前,确认渠道会把该参数转发给上游:渠道默认移除service_tier,需在渠道中开启「允许透传 service_tier」,否则用户按加价规则付费,而上游可能仍按标准服务收费。
Token 估算器与请求模拟
「Token 估算器」位于编辑器下方,「请求模拟」是其中的折叠区。两者都在浏览器中计算:估算器只计算基础表达式,不含请求规则和分组倍率;请求模拟包含请求规则,不含分组倍率。两者都不是实际账单。
| 字段/控件 | 定义与作用 | 填写要求或说明 |
|---|---|---|
| Token 估算器 | 输入「输入 token」「输出 token」和「指定输入上下文总长度」,查看「预计成本」和「命中档位」;表达式出错时显示「表达式错误」。 | 「指定输入上下文总长度」对应 len,留空时使用现有 token 总长度,可单独测试阶梯边界。表达式只要用到任一缓存、图片或音频变量,就会同时出现「缓存读取」「缓存写入」「图片缓存」「缓存写入 (1h)」「缓存写入 (12h)」「图像输入」「图像输出」「音频输入」「音频输出」9 个输入框。不含请求规则和分组倍率。 |
| 请求模拟 | 展开或收起模拟区域,预览当前规则下的费用。 | 输入变化后自动重算,无需点击运行按钮。 |
| 计费图片数量 | 表达式用到 image_count 时显示,用于模拟图片张数。 | 取值 1–128;界面提示「按请求数量预扣,按实际返回数量结算。」 |
| 模拟请求体 | 为计价规则提供请求参数。 | 必须是 JSON 对象,如 {"priority":true};无参数时填写 {},{} 表示未提供相应字段。 |
| JSON 状态标识 | 提示 JSON 语法是否有效。 | 绿色标识只代表语法通过,不代表满足所有字段要求。 |
1:1 | 编辑器光标位置。 | 表示第 1 行、第 1 列,不参与计费。 |
| 复制/格式化 JSON | 复制编辑器内容,或整理缩进与换行。 | 格式化不会修复错误语法。 |
| 模拟请求头 | 为请求头相关计价规则提供测试数据。 | 名称和值按键值对填写,值必须是字符串;可添加、删除行。 |
| JSON 模式/添加行 | 切换请求头编辑方式,或新增请求头。 | 如 {"tier":"fast"},等同于添加名称为 tier、值为 fast 的一行。 |
| 模拟时间 | 选择计价规则使用的模拟时刻。 | 支持“当前时间”和“指定时间”;表达式中的时区仍生效。 |
| 指定时间输入框 | 固定测试时刻,便于复现分时价格。 | 必须带时区,如 2026-09-18T09:00:00+08:00;Z 表示 UTC。 |
| 时间函数时区提示 | 说明时间条件按表达式内的时区判断。 | 输入时间确定时刻,表达式中的时区决定对应的小时、星期等。 |
| 模拟请求费用 | 当前测试条件下的费用结果。 | 包含请求规则,不包含分组倍率;不是已发起上游请求或最终账单。 |
| 命中档位 | 本次计算使用的计价档位名称。 | 图中的 base 是档位名称,不是用户分组。 |
| 规则命中情况 | 按规则逐条显示「已命中」或「未匹配」及倍率。 | 只在表达式含请求规则时显示。 |
LLM 辅助设计提示词
推荐使用 LLM 辅助设计计费表达式。「LLM 辅助设计提示词」只在「表达式编辑器」模式出现;内置提示词为英文,末尾会自动附上当前模型名。
You are an AI API billing expression design assistant. The user needs help designing a billing expression for an AI API gateway.

## Expression Language

Expressions are based on standard arithmetic with ternary operators.

### Token Variables

Input side:
- p — input token count (for pricing). Automatically excludes sub-categories priced separately (e.g., if cr is used, cache tokens are deducted from p)
- len — total input context length (for condition checks). Not affected by auto-exclusion; always reflects the full input length. Use in tier conditions
- cr — cache-hit (read) token count
- cc — cache-create token count (Claude 5-min TTL, OpenAI 30-min TTL)
- cc1h — cache-create token count (1-hour TTL, Claude-specific)
- cc12h — cache-create token count (12-hour TTL, OpenAI-specific)
- img — image input token count
- ai — audio input token count

Output side:
- c — output token count. Also auto-excludes sub-categories priced separately
- img_o — image output token count
- img_cr — image cache input tokens; deducted from img and cr only when the upstream reports a valid image cache breakdown
- ao — audio output token count

### p/c Auto-exclusion

p and c are fallback variables representing all tokens not separately priced in the expression. If the expression uses a sub-category variable (e.g., cr), those tokens are deducted from p to avoid double-billing. Unused sub-category tokens remain in p/c at base price.

Important: len is NOT affected by auto-exclusion. Tier conditions should use len instead of p to prevent cache hits from lowering p and misidentifying the tier.

### Built-in Functions

- tier(name, value) — labels the billing tier; must wrap the cost expression
- fixed(amount) — a finite non-negative USD price per request, used only as tier("name", fixed(0.01)); replaces token charges in that leaf. Other leaves may still use token prices. Group/request multipliers and existing tool surcharges still apply. Unsupported for task usage expressions and Realtime.
- max(a, b), min(a, b) — maximum/minimum
- ceil(x), floor(x), abs(x) — ceiling, floor, absolute value
- header(name) — reads a request header
- param(path) — reads a request body JSON path (gjson syntax)
- has(source, substr) — substring check
- hour(tz), minute(tz), weekday(tz), month(tz), day(tz) — time functions, tz is a timezone like "Asia/Shanghai"

### Price Coefficients

Numbers in the expression are $/1M tokens prices. For example, p * 2.5 means input $2.50/1M tokens.

## Expression Examples

Simple pricing:
tier("base", p * 2.5 + c * 15)

With cache:
tier("base", p * 2.5 + c * 15 + cr * 0.25)

Multi-tier (use len for conditions):
len <= 200000
  ? tier("standard", p * 3 + c * 15 + cr * 0.3 + cc * 3.75 + cc1h * 6)
  : tier("long_context", p * 6 + c * 22.5 + cr * 0.6 + cc * 7.5 + cc1h * 12)

Image model:
tier("base", p * 2 + c * 8 + img * 2.5)

Multimodal with audio:
tier("base", p * 0.43 + c * 3.06 + img * 0.78 + ai * 3.81 + ao * 15.11)

Three-tier example:
len <= 128000
  ? tier("standard", p * 1.1 + c * 4.4)
  : (len <= 1000000
    ? tier("medium", p * 2.2 + c * 8.8)
    : tier("long", p * 4.4 + c * 17.6))

## Rules

1. Every leaf branch must be wrapped in tier("name", cost_expr)
2. Use English tier names, e.g. "base", "standard", "long_context"
3. Use len for tier conditions (not p), supports <, <=, >, >=
4. Multi-tier uses nested ternary: cond1 ? tier(...) : (cond2 ? tier(...) : tier(...))
5. Price coefficients are the provider's official $/1M tokens prices
6. If cache/image/audio don't need separate pricing, omit those variables; their tokens are included in p/c automatically

Please generate a billing expression based on the model information and pricing requirements provided.

Current model: claude-opus-5-5- 打开辅助面板;在计价配置中选择“表达式编辑器”,点击“LLM 辅助设计提示词”;展开后可查看内置提示词。
- 复制提示词;点击面板右侧的“复制提示词”; 出现复制成功提示后,提示词已写入剪贴板;若复制失败,可选中文本手动复制。
- 粘贴到 LLM;打开 ChatGPT、Claude 等工具,将提示词粘贴到对话输入框;保留内置的语法说明,便于模型按系统支持的格式设计表达式。
- 补充计价需求;在提示词后追加模型名称、价格、计价方式、档位条件及倍率规则;明确价格单位;若修改已有方案,附上当前表达式并说明需要调整的部分。不要仅凭模型名称让 LLM 猜测价格。
- 生成表达式;发送完整内容,要求 LLM 返回可直接粘贴的表达式、规则解释和测试样例;对缺少或有歧义的信息,要求先确认,不要自行补全价格和规则。
- 核对并粘贴;检查价格、变量、条件边界和倍率,将表达式复制回输入框;只粘贴表达式正文,不包含 Markdown 代码围栏、解释文字或测试数据。
- 验证结果;在 Token 估算器填写用量;涉及请求或时间条件时,再使用“请求模拟”;检查费用和命中档位,并测试阈值前、阈值上、阈值后,以及字段缺失等场景。请求模拟不包含分组倍率。
- 修正并保存;如果结果不符,将表达式、报错或测试输入、实际结果、期望结果反馈给 LLM;验证通过后在价格配置界面保存;复制提示词或修改模拟样例不会自动保存计价配置。
表达式语法
用量变量
| 变量 | 名称 | 定义 |
|---|---|---|
len | 完整输入上下文长度 | 用于按长度选择档位,不受下方自动扣除影响。非 Claude 格式等于上游返回的输入 Token 总数;Claude 格式等于文本输入、缓存读取与缓存创建之和。 |
p | 基础输入 Token | 按输入基础价计费的用量。表达式单独计价的缓存、图片、音频输入会自动从 p 中扣除,未单独计价的仍留在 p 中。 |
c | 基础输出 Token | 按输出基础价计费的用量;表达式单独计价的 img_o、ao 会自动从 c 中扣除。 |
cr | 缓存读取 Token | 命中并复用提示词缓存的输入用量。 |
cc | 缓存创建 Token | Claude 5 分钟、OpenAI 30 分钟的缓存写入用量,其他上游为通用缓存写入用量。 |
cc1h | 1 小时缓存创建 Token | Claude 的 1 小时缓存创建用量。1h 是缓存有效期。 |
cc12h | 12 小时缓存创建 Token | OpenAI 的 12 小时缓存写入用量。 |
img | 图像输入 Token | 输入图像对应的 Token 用量。 |
img_cr | 图片缓存读取 Token | 命中缓存的图像输入用量。只有表达式引用、且上游提供有效的图片缓存明细时才单独拆分,否则为 0。 |
img_o | 图像输出 Token | 模型生成图像对应的输出 Token 用量。 |
ai | 音频输入 Token | 输入音频对应的 Token 用量。 |
ao | 音频输出 Token | 模型生成音频对应的输出 Token 用量。 |
image_count | 计费图片数量 | 按张计价的图片数量,1–128 的整数,未提供时为 1;可与 fixed() 档位相乘。预扣按请求数量,结算按实际返回数量。 |
- 扣除示例:上游返回输入 1000 Token(含缓存读取 200、图片 100)。
p * 3 + c * 15时p = 1000;p * 3 + c * 15 + cr * 0.3时p = 800;再加img * 2时p = 700。 - 以上自动扣除只适用于 OpenAI 等非 Claude 格式。Claude 格式返回的输入 Token 本身不含缓存,未单独计价的缓存读取和缓存写入会加回输入;扣除后小于 0 的
p、c按 0 计。 - 长效缓存写入未单独计价时:
cc1h按cc价格的 1.6 倍,cc12h按 2 倍;cc也未计价时按p价格乘同样倍数计算。
函数
| 函数 | 参数定义 | 作用/返回值 | 示例 |
|---|---|---|---|
tier(name, value) | name:档位名称字符串;value:计价表达式。 | 返回计价结果,同时记录命中档位名称。 | tier("base", p * 2 + c * 8) |
fixed(amount) | amount:有限、非负的数值常量,单位为美元/次。 | 设置按次基础价格,必须直接写在 tier() 的第二个参数位置。档位可再乘 image_count 或请求规则倍率;不能与 Token 费用相加,也不能把多个 tier() 相加;永远不会命中的分支同样要符合这些规则。Realtime 请求和任务用量表达式不支持。分组倍率、请求规则倍率和工具调用附加费照常计算。 | tier("request", fixed(0.01))、tier("image", fixed(0.04)) * image_count |
max(a, b) | 两个数值。 | 返回较大值,可用于设置计算下限。 | max(p * 2 + c * 8, 1000) 对应 Token 表达式费用至少 0.001 美元。 |
min(a, b) | 两个数值。 | 返回较小值,可用于限制某项计算值。 | min(p, 100000) 返回不超过 100,000 的输入用量。 |
ceil(x) | 一个数值。 | 向上取整。 | ceil(1.2) 得到 2。 |
floor(x) | 一个数值。 | 向下取整。 | floor(1.8) 得到 1。 |
abs(x) | 一个数值。 | 返回绝对值。 | abs(-2) 得到 2。 |
header(name) | name:请求头名称字符串。 | 返回请求头字符串;名称忽略大小写,名称和值去除两端空白;缺失时返回空字符串。读取客户端发来的请求头;值为空的请求头视为不存在,同名请求头只取第一个值。 | header("service-tier") == "priority" |
param(path) | path:请求体字段路径字符串。 | 返回请求体字段值,保留字符串、数值、布尔值等类型;缺失时为 nil。支持点分隔的嵌套路径。只读取 Content-Type 为 JSON 的客户端原始请求体;表达式用到 image_count 的图片生成请求,只提供 model、n、size、quality、parameters 这几个字段。 | param("service_tier") == "priority"、param("stream_options.fast_mode") == true |
has(source, text) | source:待检查的值;text:查找的子串。 | 将非空值转为文本后进行区分大小写的子串检查;来源为 nil 或查找文本为空时返回 false。 | has(header("anthropic-beta"), "fast-mode") |
u(key) | key:任务插件声明的用量字段名。 | 读取任务插件上报的用量,仅用于任务模型,见任务模型;普通模型的表达式使用 u() 会保存失败。 | u("seconds") * 0.4 |
_trace、_trace_int 为内部保留名,不能在表达式中使用。
时间函数
| 函数 | 返回值 | 示例含义 |
|---|---|---|
hour(tz) | 小时,0–23。 | hour("Asia/Shanghai") >= 21 表示当地时间 21 点及以后。 |
minute(tz) | 分钟,0–59。 | minute("UTC") < 30 表示当前小时的前 30 分钟。 |
weekday(tz) | 星期,0–6;0 为周日,6 为周六。 | weekday("Asia/Shanghai") == 0 表示周日。 |
month(tz) | 月份,1–12。 | month("Asia/Shanghai") == 12 表示 12 月。 |
day(tz) | 当月日期,1–31。 | day("Asia/Shanghai") == 1 表示每月 1 日。 |
- 参数为 IANA 时区名,如
Asia/Shanghai、UTC。可视化编辑器的阶梯条件会提示无效时区;在表达式编辑器中写错或留空时不会报错,服务端和浏览器模拟都按 UTC 计算。 - 预扣和结算各按当时的时刻求值;请求跨越时段边界时,按结算(请求结束)时刻所在的时段计费。
常用语法
| 语法 | 含义 | 示例 |
|---|---|---|
+、-、*、/ | 加、减、乘、除。 | p * 2 + c * 8 |
>、>=、<、<= | 大小比较,返回真假。 | len <= 200000 |
==、!= | 相等、不相等。 | param("priority") == true |
&& | 逻辑“且”,两个条件都满足。 | len < 32000 && c < 200 |
|| | 逻辑“或”,至少一个条件满足。 | hour("UTC") >= 21 || hour("UTC") < 6 |
! | 逻辑取反。 | !(param("priority") == true) |
条件 ? A : B | 条件为真执行 A,否则执行 B。 | len <= 200000 ? tier("short", p * 2) : tier("long", p * 4) |
(...) | 分组,明确计算顺序。 | (基础表达式) * (条件 ? 2 : 1) 是结构示意,需替换其中中文占位内容。 |
"文本"、true、false、nil | 字符串、布尔值与空值。 | true 与 "true" 不是同一种类型。 |
Token 估算器和请求模拟在浏览器中计算,只支持上表中的运算符、%、括号以及字符串、true、false、nil;写法超出时提示「此表达式无法在浏览器中模拟。」,不影响服务端保存和实际计费。
预扣、结算与日志
- 预扣:请求发出前,用本地估算的输入 Token 同时作为
p和len,c及其他用量都按 0 求值;Token 档位的结果再乘「输入预扣倍率」(见额度设置),按次档位不乘;最后乘分组倍率。因此以c为条件的分支在预扣时一律按c = 0判断。预扣结果小于 0 时请求被拒绝。 - 结算:上游返回后按实际用量重新求值,与预扣额的差额多退少补;结算时求值失败,按预扣额结算。
- 日志:消费日志记录命中档位
matched_tier、计费单位billing_unit、按次价格fixed_price、图片数量image_count、请求规则request_rules(含每条是否命中)和 base64 编码的表达式全文expr_b64。这些字段用户在自己的日志详情中也能看到,不要在表达式中写入不希望用户看到的内容。
保存校验与常见报错
- 点击「保存模型价格」后,服务端逐个模型校验:表达式必须能编译;再用 7 组固定用量(含全 0 和超大的
len)分别配合 2 种请求上下文(空请求;带anthropic-beta: fast-mode-2026-02-01请求头和service_tier: fast请求体)试算,每次结果都必须是有限且不小于 0 的数;普通模型不能使用u()。一次提交多个模型时,任一模型校验失败,整批都不保存。 - 试算只覆盖上述输入;由其他请求参数、请求头或时间条件触发的分支不会逐一检查,需自行确保每个分支的结果都不小于 0。
- 打开页面后价格已被他人修改时保存会被拒绝,处理方式见系统设置概览。
- 常见报错
| 报错片段 | 含义 | 处理 |
|---|---|---|
expr compile error: … | 语法错误,或使用了不存在的变量、函数 | 检查拼写、括号、引号和逗号 |
fixed price must be a finite, non-negative numeric literal… | fixed() 的金额不是非负数字常量 | 改为数字常量,如 fixed(0.01) |
fixed pricing requires tier(name, fixed(amount)) leaves… | fixed() 档位与 Token 费用相加,或结构不符 | 每个按次档位写成 tier(名称, fixed(金额)) |
vector {p=…, c=…}: result must be finite and non-negative, got … | 某组试算结果为负数或无穷大 | 检查减法、除法和各分支 |
expression references usage keys […] but the model has no task plugin usage schema | 普通模型使用了 u() | 删除 u(),或确认该模型由任务插件提供 |
identifier "_trace" is reserved for internal use | 使用了保留名 | 换用其他名称 |
model pricing changed; reload before saving | 版本冲突 | 点击「重新加载定价」后再修改 |
从旧模式转换
- 选择「按 Token(已弃用)」或「按次(已弃用)」标签时,页面提示「旧定价模式已弃用。可将当前价格转换为计费表达式草稿,保存后生效。」并提供「转换为计费表达式」按钮。点击后打开「定价迁移预览」左右对照,确认「应用到草稿」后切换为计费表达式草稿,点击「保存模型价格」后才生效。已有表达式草稿时该按钮不可用。
- 生成规则:按 Token 模式生成
tier("base", p * … + c * … …),基础输入单价 = 模型倍率 × 2(美元 / 百万 Token,按默认每美元额度),并按已配置的补全、缓存、图片倍率生成对应项;按次模式生成tier("request", fixed(价格));图片按次价格生成tier("image", fixed(价格)) * image_count,并附带原有的尺寸、质量倍率。 - 以下情况不能自动转换,界面会显示原因:任务插件模型、视频、Realtime、依赖上游费用反推缓存写入的 OpenRouter Claude 定价、同一模型在 Gemini 与 OpenAI 接口上音频价格不同、未配置输入价格、模型路由无法验证、已经是计费表达式。
- 转换后,旧价格字段仍然保存,可切回旧模式;预扣与舍入改按计费表达式规则,生效单价不变,单笔舍入后的费用可能略有差异。
任务模型
- 由任务插件提供的模型(如视频、异步图片任务),编辑面板会多出一排提供商标签(如「默认」「普通 OpenAI」和各插件)。每个插件标签有「为此服务方单独设置」开关,关闭时沿用模型级表达式或价格。
- 任务表达式用
u("字段")读取插件上报的用量(如秒数、张数),结果直接是美元,不再除以 1,000,000;不支持fixed()。Token 估算器对这类表达式提示「此表达式需要任务用量数据才能估算费用,请检查模型的任务插件配置。」
常见问题
- 估算结果与实际扣费不一致? Token 估算器不含请求规则和分组倍率,请求模拟不含分组倍率;实际扣费还要乘分组倍率,按结算时的实际用量和时间重新计算,工具调用附加费另计。
- 阶梯没有按预期切换? 检查条件是否用了
p而不是len(缓存命中会让p变小);以c为条件的分支在预扣时按c = 0判断,结算时才按实际输出切换。 - 分时价格错位? 检查时间函数的时区名称。写错或留空时按 UTC 计算,不会报错。
- 请求规则没有生效?
param()只读取 JSON 请求体;用请求模拟核对条件是否「已命中」,再到消费日志的请求规则记录中确认。